写真 → 言葉 → 地物ID → 街
使っているのは、すでにある3つのデータだけです。みちよみ(街路写真を AI が読んだ言葉)、PLATEAU(国の 3D 都市モデル。地物ごとに ID を持つ)、LOOVIC(その場を知る人の声)。この3つを、PLATEAU の地物IDという共通の住所に結びます。
Mapillary
CC BY-SA 4.0
1枚 = 1件。看板・建物・歩道・危険…
振り分け先・左右・距離・出典の JSON Pointer
建物・道路・都市設備・街路樹。CityGML に書き戻す
元の言語化の文と値をそのまま使う。地物の上では意味のない「(右・約15m)」のような位置の注記だけを外す。
紐づけでは、VLM に文を書かせない。写真に重ねた記号から「どの地物の話か」を選ばせ、その確率を残す。
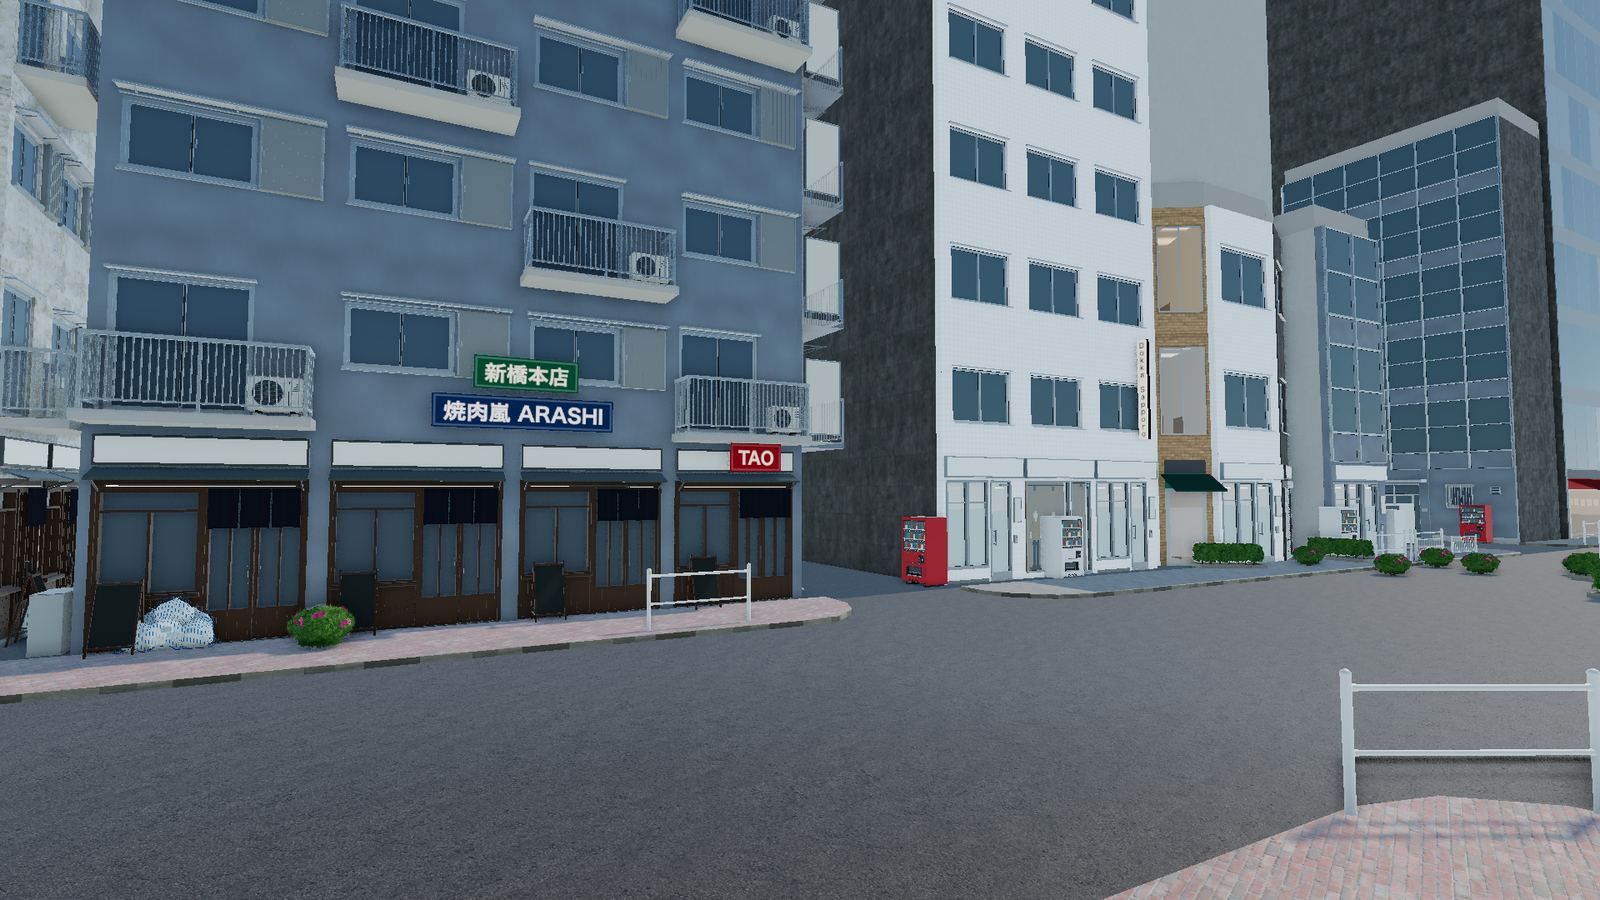
街の姿は「言葉から描いた想像図」。言葉の無い壁に窓や店を描かない。素材の語が書かれた壁だけをその素材にする。
写真1枚を、AI が言葉と値で読む
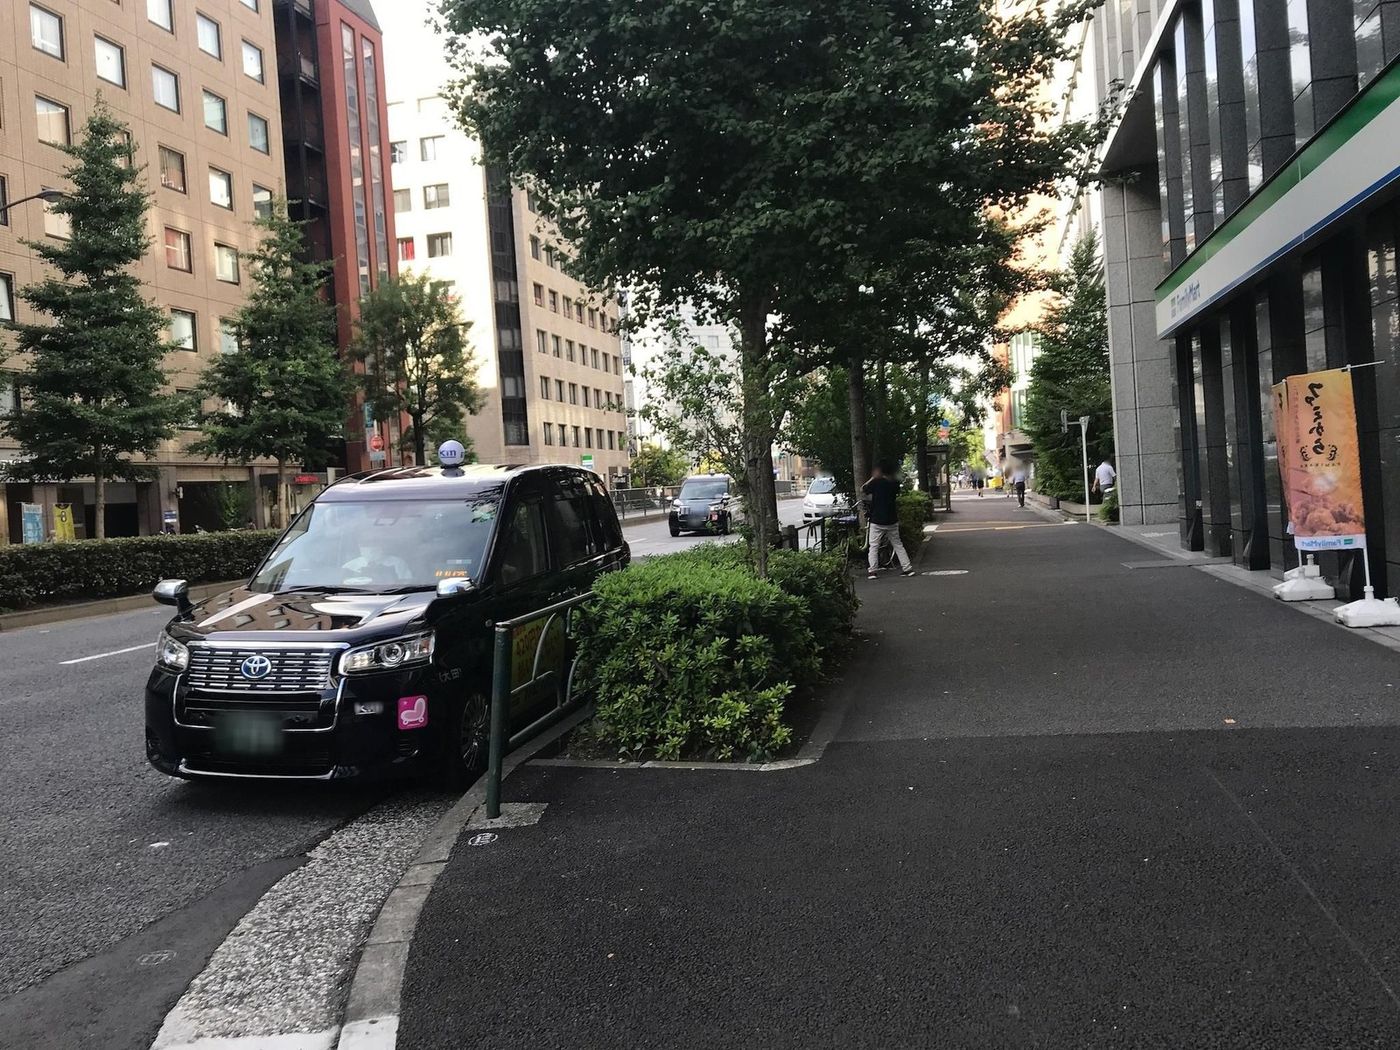
みちよみは、街路写真1枚ごとに VLM が書いた構造化 JSON です。約191万場面(東京を中心)。看板の文字、建物の種類と見た目の階数、歩道の幅、舗装、危険の手がかりまで、文と数値で持ちます。例は、2026年9月27日朝のごみ回収の実録が始まった場所、新橋のファミリーマート前。
JSON を「どの地物の話か」で分ける
1件の JSON を、PLATEAU の地物に振り分けられる単位の記述に分けます。文面は元の値をつないだだけ。記述ごとに振り分け先の種類(建物・都市設備・街路樹・植樹帯・歩道部・車道部)、左右、距離、そして元の JSON のどこから来たかを示す JSON Pointer を持ちます。(mlink/statements.py)
記述にカーソルを合わせると、左の JSON の元の場所が光ります。
振り分けの規則(上から最初に当たったもの)
| 記述の言葉 | 振り分け先 |
|---|---|
| 看板・店名、建物の種類・階数・外装 | 建物 |
| 信号・街灯・標識・電柱・柵・消火栓・マンホール・横断歩道 | 都市設備(LOD3) |
| 街路樹・高木・ケヤキ・イチョウ… | 街路樹 |
| 植栽帯・植え込み・分離帯・交通島 | 植樹帯・島 |
| 歩道の幅・段差・縁石・点字ブロック・車いす | 歩道部(左右) |
| 車線・標示・舗装・ひび・駐車・見通し | 車道部 |
危険・不具合の手がかりも同じ規則で、その原因の地物へ振り分けます(「根上がり」→ 街路樹、「駐輪で歩道が狭い」→ 歩道部)。写真の中の位置の言葉(右・左・正面)と距離(約15m)は、次の紐づけの手がかりになります。
写真に PLATEAU を重ね、AI は記号を選ぶだけ
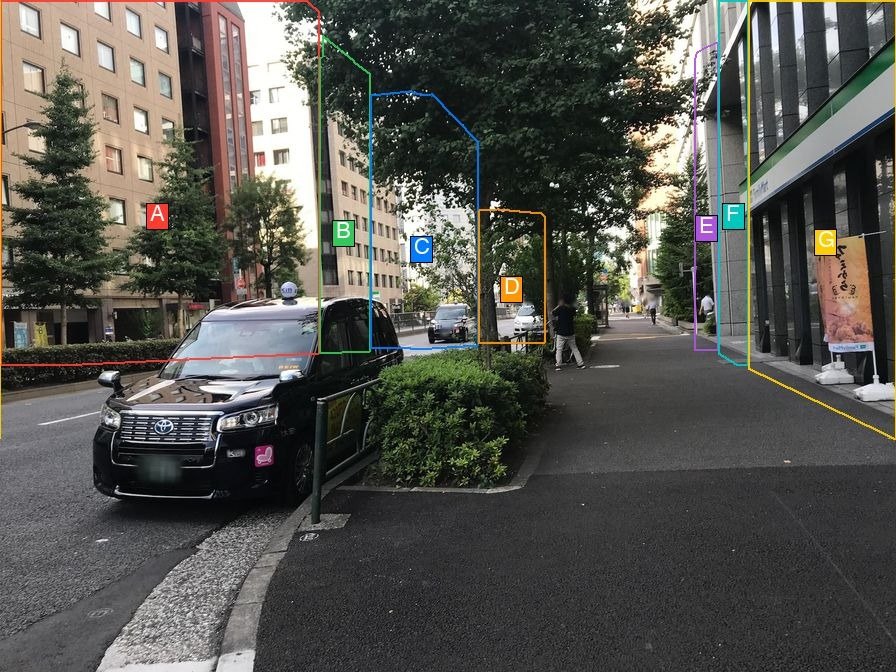
「右の看板」がどの建物かを決めるのに、AI に文章を書かせません。写真の画角に PLATEAU を描いて候補の地物に記号を重ね、VLM には「この記述が指す記号」を選ばせるだけにします。答えは英字1文字に制限し、出力の確率から選択肢ごとの確からしさを出します。
- 撮影位置と向きを補正する
Mapillary の SfM 補正後の位置・方位を、写真の建物の見え方と PLATEAU の建物が重なるように合わせる(方位 ±30°、横 ±6m、前後 ±4m。効いたときだけ使う)。
- 画角に PLATEAU を描き、候補を出す
建物ごとに色の違う「建物IDの画像」を描き、写っている地物と、左右・距離から見た幾何の確率を作る。
- 候補に記号 A〜G を重ねる
写っていない・該当しないときの逃げ道として Z も必ず入れる。
- VLM は記号を選ぶだけ
出力を JSON Schema で英字に制限し、トークンの対数確率を選択肢の確率にする。文は生成しない。
下の記述を押すと、写真の記号と候補が連動します。
採る・採らないの規則
車・自転車からの写真は目視で15件中4件と悪かったため、確率0.9以上だけを採る。少数の目視なので「確かめた範囲では」の数字です。
地物IDごとに束ね、CityGML に書き戻す
結んだ記述を地物IDごとに集めます。同じ店の看板を別々の撮影列で読んでいれば多数決でそろえ、歩道の幅のような値は中央値・最小・最大・観測数に。こうして、PLATEAU の形に「その場所がどう見えるか」という言葉の層が付きます。
紐づけの方法()
結んだ地物
言語 LOD — 記述の細かさを、形の LOD と同じ梯子で
街路樹
結んだ地物だけを元の CityGML から抜き出し、gen:genericAttributeSet name="みちよみ" を CityGML 2.0 の順序どおりに差し込む。値は gen:doubleAttribute などの数値属性になるので、PLATEAU VIEW や QGIS で条件にかけられる(GeoJSON も出力)。
意味ごとに分け、言葉が素材と部品を選ぶ
地物の言葉を6つの意味に分けます。そして、文に書かれた素材と色の語から CC0 の素材を選んで色を合わせ、建物の種類と1階の業態から部品を選びます。画像は生成していません。
 素材「タイル」
言葉で選ぶ部品 —
建物の種類(マンション・オフィス・住宅・ホテル・工事中)と1階の業態(コンビニ・飲食・居酒屋・医院・美容…)の語で選ぶ。部品は GPT-6 Pro が Blender MCP で Blender を操作して作った自作モデル。外部の3D素材は使っていない。
字が一粒ずつ、その地物の面へ飛ぶ
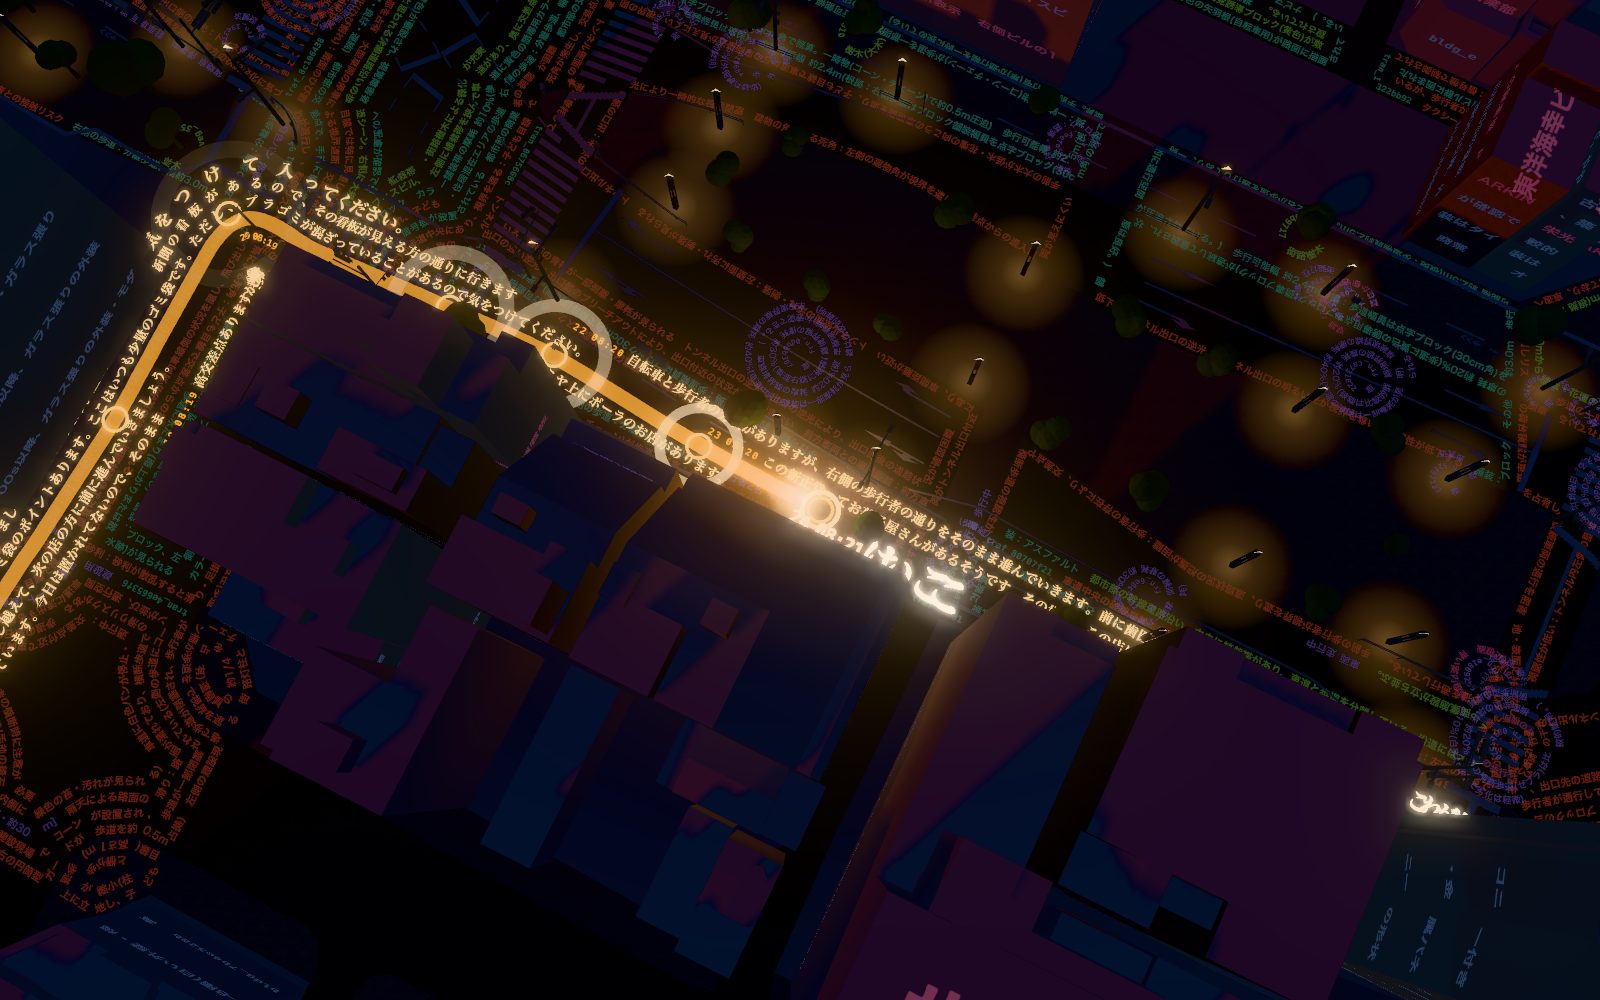
導入「言葉がつくる街」は、この一連の流れを約67秒で見せます。約14万字の一字一字が、自分の文が結ばれた地物の面を知っていて、そこへ飛び、PLATEAU の形を下から書いていきます。
1字 = 1インスタンス、場所を2つ持つ
(街を囲む円筒)
(壁・道・根元)
字は 15万 個のインスタンス。それぞれが「地平の位置」と「自分の文が結ばれた地物の面の位置」を持ち、1回の描画で出す(M4 Max で毎秒60コマ)。
画面は時刻だけで決まる
動きは頂点シェーダーが時刻の値だけから計算する。だから一時停止・章の飛ばし・巻き戻しが自由。
使う字だけの SDF アトラス
文に出てくる 1,239 字だけを、閲覧者のブラウザのフォントから距離場(SDF)にして 1 枚の画像に詰める。フォントファイルは配らない。ゴシック=みちよみ、明朝=人の声、等幅=ID。
壁の帯を、開けた面から
PLATEAU の壁の多角形(LOD2)を高さごとに切って帯にし、次の壁まで最も遠い「開けた面」から反時計回りに文を流す。文が多いほど帯の間隔が詰まり、あふれた文は屋上の縁へ。
道の輪郭の内側を巡る
交通領域(歩道部・車道部)の面を 0.55m から 1.05m おきに内側へ縮めた輪に、字の上を内側に向けて流す。PLATEAU で同じ路面を二重に覆う2系統(tran_・traf_)の 1,120 組は、面を1枚にまとめて文を合わせる。
素材の語が光ってから、素材になる
広がる走査の輪が建物に届く少し前、その建物の文の中の素材の語(「タイル」「ガラス」)が光って大きくなり、そのあと壁がその素材で下から現れる。
そこに、歩いた人の言葉を重ねる
「ここは朝早くは音を鳴らしちゃいけないので、気をつけて入ってください。」LOOVIC 現地記録 No.13 · 2026-09-27 朝 · 新橋(書き起こしのまま)
写真の言葉は「どう見えるか」しか分かりません。ここでは、こうするという判断は、その場を知る人の声にあります。2026年9月27日の朝8時、ごみ回収の道を歩きながら LOOVIC で残した声を、声は無加工のまま、位置だけを PLATEAU で締め直して、同じ地物IDに結びました。
補正した道が通る面(PLATEAU の交通領域)
位置は GPS のままではなく、声と同時に撮った写真・公式の店舗位置・曲がる順序から、話した人の立ち位置を補正しています。指している対象(「これ」「その店」)は、立ち位置とは別の候補として持ちます。AI はこの記録を先に全部読めるので、ロボットのデモでは、人が着いてから話した条件を、手前で先に使って動きを決めます。
正直に書いておくこと
壁の素材・部品は言葉から描いたもので、写真は貼っていない。素材の語が無い壁は無地のまま。建物の種類から素材を推測しない。
車から撮った密集街区では、記号の輪郭が実物と5〜8°ずれて隣の建物を選ぶことがある。だから車・自転車の場面は確率0.9以上だけ採る。
言葉は 2015〜2026年の写真、形は 2025年ごろの PLATEAU。建て替わった建物には、前の建物の言葉が載ることがある。
左右と撮影位置だけで決めたもの。確からしさは上限0.7の目安として扱う。
約14万字のうち、文の多い道などで面に置ききれない約3.6万字は、地平から消える見せ方にしている。
この頁の数値は、発表用に数え直した present/data/numbers.json(出所と数え方つき)と、導入のデータ prologue.json から。書き換えていない。